

TikTok vuele al lío. Tenemos a la Comisión Europea confirmando de que TikTok es un brutal sistema de efecto madriguera (rabbit hole) en la recomendación de vídeos; cuánto más interactúas con un contenido, sea perjudicial o lo que sea, más te lo muestra. Dejando claro lo mismo que ya les ha pillado a los META, YouTube y la propia TikTok: medidas de mitigación que no mitigan y algoritmo trampeado que prioriza la visualización de contenido a la elección de muestra menos de ese tipo concreto.
La DSA abrió la veda normativa que va a continuar la Digital Fairness Act (de la que luego hablamos por haber publicado borrador de la CE), pero sin que parezca que se vean grandes avances de cumplimiento en tiempo prudencial. Otro caso más en el que quedará claro que la empresa sabía y siempre pretendió hacer lo que hacía, el mareo de que implementan medidas y la constatación en la siguiente sanción de que nunca activaron las necesarias para evitar bajada de engagement o los números.
Money makes the world go around, the world go around.
Parte de las mismas conclusiones atroces de que META sabía que su algoritmo provocaba casos de dismorfia corporal en menores (Instragram sobre todo), y que el filtro para prevenir que los pederastas contactaran con ellos no era efectivo Casos de Nuevo México y California), lo tenemos en la investigación que Maldita acaba de publicar. La misma sobre la que se ha basado el Ministerio de Juventud e Infancia para pedir a TikTok que suspenda servicios en España. Adelantando que no les van a hacer ni caso, metió a la AEPD en el ajo para que valore ordenar la suspensión del tratamiento.
Justo la propia AEPD, en menos de 24 horas, ha emitido comunicado diciendo que actuará de oficio para requerir a TikTok información sobre lo que hacen para reiterar el contenido aludido por Maldita, ordenará bloqueo que impida el acceso al mismo tras revisar lo que aporte, y dará traslado a varios sitios: la irlandesa como autoridad principal por establecimiento principal de TikTok, al EDPB y la propia Comisión Europea competente en DSA.
El Garante en 2021 suspendió el tratamiento de la parte de menores por debajo de la edad legal de tener cuenta, por el fallecimiento de una niña tras hacer un reto potencialmente mortal, así que parecería un alcance menor.
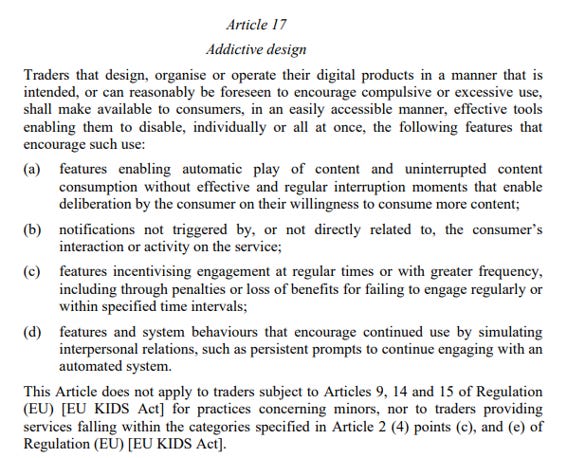
Tampoco ayuda que la normativa estatal para dar galones a la CNMC como autoridad nacional en materia de la DSA, Gobierno Español. Ni que sea un problema de base de diseño y funcionamiento de gran parte de estos proveedores. Sigue saliendo rentable pagar sanción y hacer lo mismo, aun cuando son millonarias. Y si se mantiene la redacción del artículo 17 de la DFA sobre “diseño adictivo” que os dejamos en otra sección, tampoco va a solucionarse nada de nada.
Hay que dar las gracias muy fuerte por no ser menores en estos tiempos.
Estás leyendo ZERO PARTY DATA. La newsletter sobre actualidad y derecho tecnológico de Jorge García Herrero y Darío López Rincón.
En los ratos libres que nos deja esta newsletter, resolvemos movidas complicadas relacionadas con la normativa de protección de datos personales e inteligencia artificial. Si tienes de alguna de esas, haznos así con la manita. O contáctanos por correo en jgh(arroba)jorgegarciaherrero.com
🗞️Noticias del Mundodato 🌍
.- La Digital Fairness Act se va acercando con la noticia de que se ha filtrado el borrador del texto que va a presentar la Comisión Europea. Ya pasó con la EU Kids Act filtrada no mucho antes de que se sacara el borrador, y ahora igual con la propuesta de texto de la Comisión Europea publicada ayer.

Es la norma que va a poner coto concreto a los patrones oscuros y diseño adictivo, la parte ya conocida de limitar los micropagos en los videojuegos (ya se sabía, y en base a los principios de la CPC/ investigación sobre juegos concretos que se hicieron, transparencia en precios, o el tema del perfilado comercial sobre menores o el “marketing de influencers”.
También mete el cada vez más preocupante precio personalizado, aunque desde la óptica de no aplicarse a personas vulnerables y menores. Y desde la de que el perfilado ya puede ir cumpliendo con lo que dice el RGPD, y que el cumplimiento de la obligación no implica la subsiguiente de meter verificación de edad (el mismo enfoque que la DSA). Lo divertido es que deje caer el que se sepa razonablemente si es menor o vulnerable. Eso que Discord ya decía que podía hacer por cómo parametrizan lo que pinchamos, abrimos, buscamos o navegamos.
Quedaba en duda si se metería algo de la preservación de Stop Killing Games, pero podremos verlo cuando el Parlamento Europeo pase a hablar. La Comisión les metió la de típica de la autorregulación, pero el Parlamento el que les hacía más ojitos a la iniciativa.
Ojo con el tema del diseño adictivo. Se ve que a nadie se le ocurrió imponer el requisito de todo estuviera desactivo por defecto. Si alguien está ya en la rueda de la adicción de un contenido que lo es por diseño, es de bombero pensar que ejercerá limitación sin ayuda externa. Y ante algoritmos diseñados para que ni un adulto sea consciente de la manipulación, no está de más partir de la misma posición inerme de un menor.
.- Cualquier artefacto digital contiene entropía suficiente para contar más de lo que su creador pretendía, por ejemplo, para geolocalizarte. La comunidad de Lobsters discute un vídeo que demuestra cómo el espectro de audio de una grabación cualquiera contiene desplazamientos Doppler producidos por hélices de aviones que sobrevuelan la zona. Cruzando esas firmas con la base pública de posiciones de aviones en Estados Unidos se puede triangular dónde y cuándo se grabó el clip sin un solo metadato.
.- Pressure cooker, the film: El supervisor europeo investiga a Europol tras la investigación conjunta de Computer Weekly, Correctiv y Solomon que destapó que la agencia almacenó durante años volúmenes ingentes de datos sensibles en un repositorio creado dentro de su Computer Forensics Network sin las salvaguardas de seguridad y protección de datos que exige el Derecho de la Unión. El EDPS confirma un ejercicio de “fact finding” de varios meses, apoyado en testimonios anónimos de altos cargos y documentos filtrados que describen un entorno paralelo de tratamiento, apodado “pressure cooker”, donde las salvaguardias sencillamente brillan por su ausencia.
📖 Documentos dateros muy cafeteros ☕️
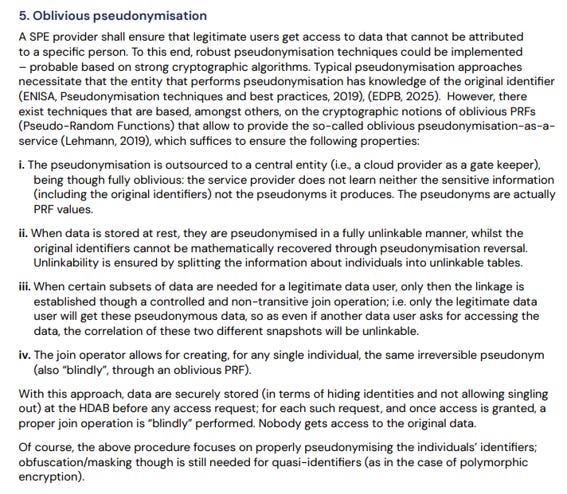
.- La guía que la semana pasada sacaron en comandita la AEPD y la autoridad griega sobre ETS (entornos de tratamiento seguro), está interesante. Es un tema muy concreto que toca la Data Governance y los espacios de datos, pero recuerda PETS de las curiosas: el famoso cifrado homomórfico, cifrado polimórfico o la seudonimización ciega.
.- El AG Szpunar le parte la cara a un listo. Un particular rastreó con un crawler miles de webs que cargaban las Google fonts, provocó las visitas con software y envió cartas reclamando 170 euros por baraba; el método se usó más de cien mil veces. El Abogado General confirma el enfoque relativo de Breyer: la IP dinámica es dato personal para el destinatario con medios razonables de identificación y, de forma indirecta, para la web emisora cuando sabía o debía saber que Google podía identificar al usuario. Pero el artículo 82 exige daño real: quien busca deliberadamente la transferencia no pierde el control sobre sus datos, los usa exactamente como planeó. Siguiente pregunta.
💀Death by Meme🤣
¿Tenemos autoridad moral para descojonarnos de Jensen Huang, el único CEO de la BigTech mundial que no se ha conducido en los últimos años como un supervillano de Marvel?
No.
¿Nos inhibiremos entonces de incluir una tonelada de chistes y memes sobre el tema?
POR SUPUESTO QUE NO.
Que la maltrecha burbuja de la IA fuera a reventar del todo por la pitopausIA del CEO de Nvidia es algo que, con toda franqueza, no vimos venir.
Afortunadamente, los chistesitos ya los han hecho personas humanas muuuucho más grasiosas que nosotros: sólo vamos a recopilar algunos de los que han hecho de la semana, una auténtica gossadera.
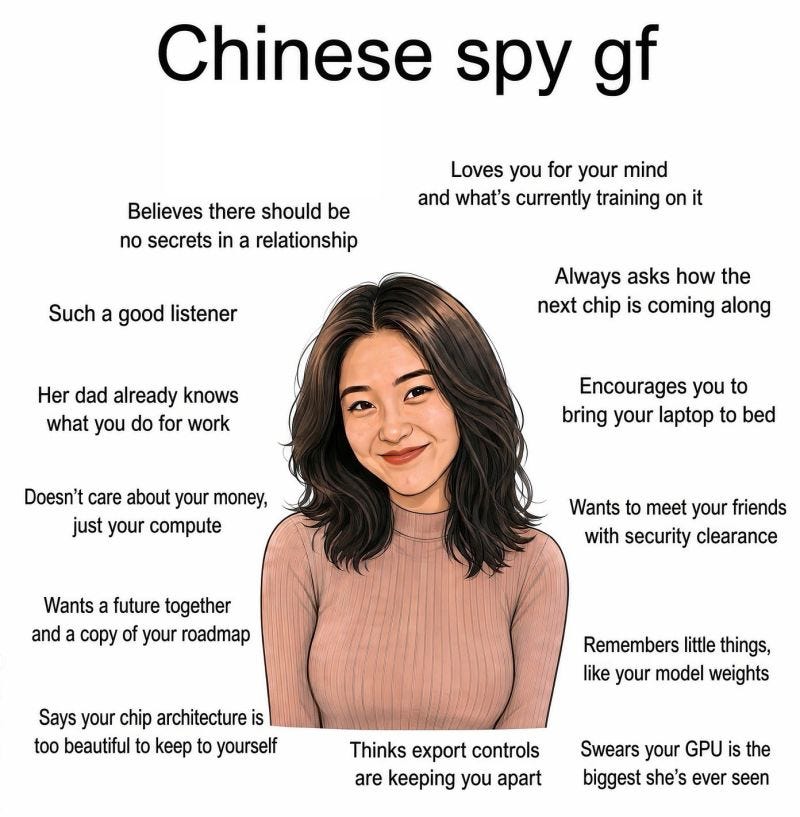
Lo del CEO de NVIDA tiene muchas lecturas y posibles consecuencias mundiales, pero lo primero siempre serán los memes. Y la confirmación de si Jensen puede considerarse James Bond honorífico por protagonizar una de las películas antiguas del personaje: “La espía que amó”. O la versión geopolítica actualizada de “From Russia China with love”.
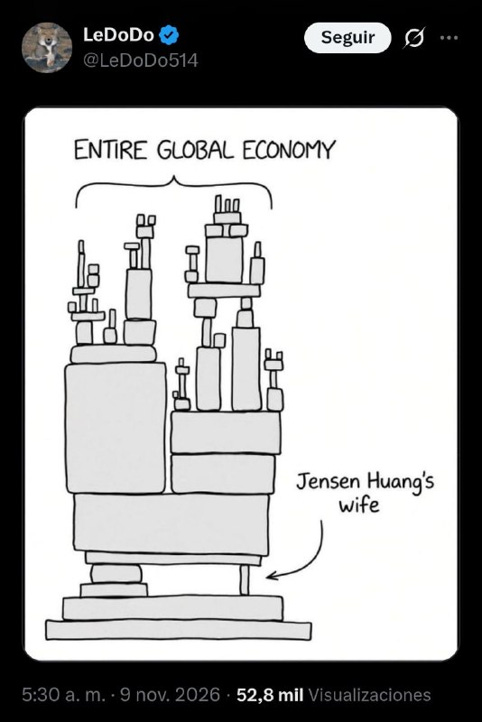
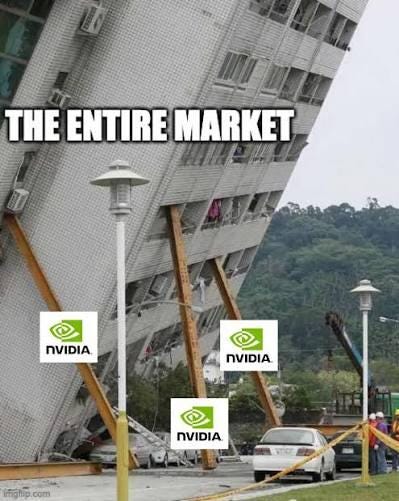
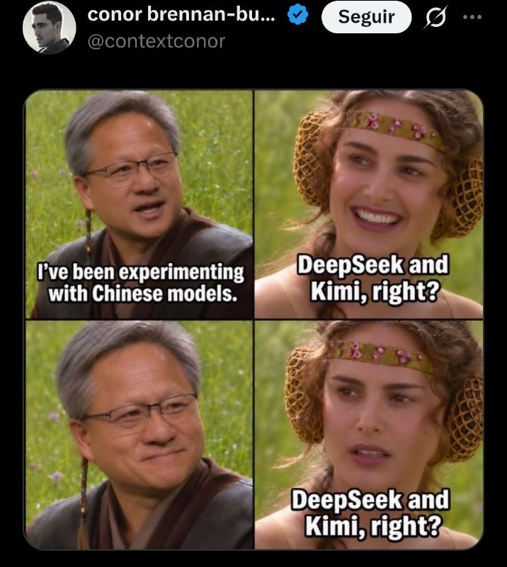
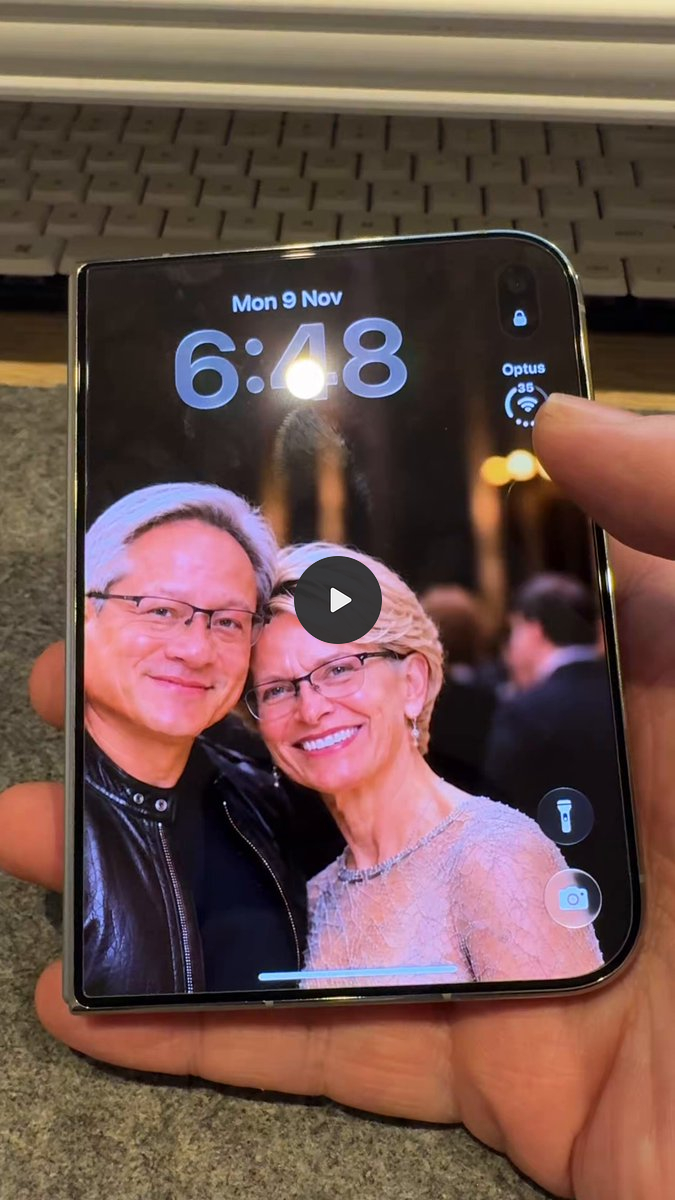
Y hasta han conseguido encontrarle una utilidad al plegable que Apple ha traído de nuevo al debate de si son timo o no:

🤖NoRobots.txt o Lo de la IA
.- Dos autoridades europeas se pronuncian, casi a la vez (y con criterios divergentes) sobre el uso de la IA en el contexto de las Administraciones públicas.
La Autoridad de Hamburgo, en este doc sobre “LLMoin” entierra sus otrora cacareadas teorías sobre “los LLMs no contienen datos personales” y asume el principio contrario: no se puede afirmar que un LLM no haya absorbido datos personales, así que se parte del principio contrario, hasta que el responsable demuestre que es “anónimo” ya si eso.
Pero por otro lado, se muestra mucho más flexible que el Garante en cuanto a la implementación de la supresión de datos personales. En la misma línea declara que el impacto de un entrenamiento eventualmente ilícito se reduce si a nivel de sistema se impide la salida de datos personales.
Y se conforma con esto: Hamburgo reconoce que, si hay datos en los parámetros, el art. 17 se proyecta sobre el modelo. Pero admite que el borrado a nivel de parámetros no es hoy técnicamente viable y que el machine unlearning no está maduro. Así que se conforma con medidas de mitigación.
El Garante sigue siendo la autoridad más exigente. Se pronuncia sobre un reglamento en desarrollo una ley provincial que habilita el entrenamiento de modelos de IA con el patrimonio informativo público. Me quedo con dos detalles:
Uno.- El training de un modelo con datos personales procedentes de registros públicos no puede contener las categorías del art 9 (sensibles) y 10 (infracciones penales) sin ley habilitante. Sin ley, sólo caben datos sintéticos o seudonimizados.
Dos.- La DPIA aportada por Trento reconocía que, una vez consolidado el entrenamiento, la rectificación y la supresión no se reflejarían en los parámetros del modelo y solo corregirían la fuente para ciclos futuros (hemos visto aquí suficientes papers que acreditan que hoy por hoy, prometer otro cosa es pensamiento mágico). El Garante, sin embargo, califica ese riesgo de potencialmente sistémico y considera que vulnera los arts. 16 y 17. Exige medidas que garanticen la plena efectividad de esos derechos con independencia del sistema o modelo utilizado.
¡Beef!. Esto sólo se puede solucionar con un juicio por combate a lo Juego de Tronos.
.- Revolut recorta diez veces sus costes de inferencia para programar abandonando Claude y Codex como opción por defecto y sirviendo el modelo chino de pesos abiertos GLM (primero 5.1, luego 5.3) sobre 56 GPU Nvidia B200. David Abitbol, responsable de infraestructura, contó en el AI Engineer que los límites de presupuesto iniciales (ingenieros gastando mil o diez mil dólares mensuales sin retorno claro) empujaron al autoalojamiento a 0,30 dólares por millón de tokens. Las mayores ganancias no vinieron de más GPU, sino de cuantización NVFP4, prefill y decode desagregados y ventanas de 256.000 tokens porque, en sus palabras, el contexto de un millón es un timo. Y subraya lo evidente: un modelo chino plantea dudas de privacidad y seguridad, pero sitúa el riesgo real en las API alojadas en China; ejecutado on premeises o en nube regional, no hay nada que temer.
📃El paper de la semana
.- Model collapse (y no, esta vez no nos referimos a la pariente de Huang, harhar): Los modelos de IA colapsan cuando se entrenan con datos generados recursivamente, según el artículo en Nature de Shumailov, Shumaylov, Zhao, Papernot, Anderson y Gal. Sé que el paper es viejuno, pero me lo he leído esta semana.
Si GPT-{n} aprende de un internet cada vez más poblado por texto de GPT-{n-1}, el uso indiscriminado de contenido sintético produce defectos irreversibles en los modelos resultantes, porque las colas de la distribución original (lo raro, lo minoritario, lo improbable) desaparecen generación tras generación.
La consecuencia que aventuraron hace dos años hoy es evidente: los datos sobre interacciones humanas genuinas con sistemas se vuelven progresivamente más valiosos conforme la web se llena de slop sintético
Autor: Ilia Shumailov, Zakhar Shumaylov, Yiren Zhao, Nicolas Papernot, Ross Anderson, Yarin Gal.
🛠️Herramientas útiles
.- ¿Quieres saber qué infiere TikTok de tu cara, sin subirle tu cara a TikTok?. Puedes utilizar esta web (se ejecuta en tu dispositivo sin subir archivos) porque es muy interesante. Un buen ejercicio de biometría no identificativa unhinged.
.- Por fin, hemos podido trastear un rato con la aplicación de FRIAs que sacó la APDCAT. A primera vista no parece nada muy especular y distinto de aquella de PIAs, es decir, que te sirviera más para salvar algún susto con entregable limitado con toda la estructura que tendría que tener.
Lo que relevante es la parte que no se ve: la metodología validada y de un reputado especialista, que hace que tenga sustento real la categorización del propio riesgo. Sin eso, la autoridad practicaría un auto de fe disuasorio con la empresa que fuera. Lo mismo que en una LIA o PIA sin la parte de riesgos sujeta a metodología contrastable y válida.
🙄 El chorradón final
Si echas de menos algun doc, comentario o chorradón que manifiestamente debería haber estado en el Zero Party Data de la semana, escríbenos o deja un comentario y lo valoraremos para la próxima.