

Suelo leer lo que escribe Peter Craddock porque tiene una perspectiva muy distinta a la mía, y eso siempre ayuda a (i) entrenar el pensamiento lateral y a (ii) detectar argumentos resbaladizos.
Entiendo por “argumentos resbaladizos” esos que tienen gran potencial comercial porque, ejem, expresan justo lo que quieren oír tus clientes más… inquietos, pero carecen de fundamentos sólidos más allá de declaraciones del tipo “el TJUE aún no ha concretado explícitamente que esto esté prohibido”.
Pues bien, el último escrito largo de Craddock se titula, posiblemente -aunque no creo- de forma autodescriptiva “slippery arguments”, y trata diversos aspectos jurídicos sobre el uso de Smart glasses
Selecciono y comento los fragmentos que me resultan más ominosos. Utilizo siempre como ejemplo las Meta Glasses, aunque el autor no lo haga.
1.-

Peter Craddock ha estado en pocas o ninguna playa en los últimos dos veranos o no diría esto.
2.-

En realidad, la excepción doméstica aplica aunque conozcas a las personas que grabas, otra cosa muy distinta es si publicas la grabación. Y otra cosa son los derechos de imagen, etc, pero esto se trata más adelante en el doc.
Y aunque al usuario le aplique la excepción doméstica, eso no significa que -si hay tratamiento de datos personales- no exista responsable del mismo.
3.-

Hay un grupo de juristas que interpretan la doctrina SRB-Scania (y en general el RGPD) de la forma más restrictiva posible. La línea roja suele ser la última sentencia del TJUE que les quitó la razón (caso “IAB Europe”, anybody?), y se busca en ella cualquier fleco o hueco para tratar de seguir sosteniendo lo insostenible... hasta el siguiente palo judicial.
En este caso, lo que se trata de decir es que, si el Usuario de turno graba a personas que no puede identificar, no aplica el RGPD porque no hay dato personal. Como he dicho, en realidad, si graba y no publica no le aplica el RGPD por la propia excepción doméstica, con independencia de su capacidad para identificar. Y si publica más allá de su círculo de amigos más íntimos, aplica el RGPD. Y además lo hace en modo corresponsabilidad entre plataforma y usuario, con el límite determinado, efectivamente, por la identificabilidad de los sujetos incluidos en el contenido.
La mención a las personas públicas es otro truco más viejo que el betún: elevar la excepción a regla general. Las personas públicas tienen una protección muy restringida de su derecho de protección de datos personales, así que son un buen ejemplo -bien que excepcional- si lo que se pretende es remar a favor del uso de smartglasses.
4.-

Aquí el autor se está olvidando interesadamente de un par de cosas:
.- Meta es cofabricante del dispositivo y es la plataforma en la que se publican los contenidos. Aunque Meta no accediera a los datos tratados, tiene una responsabilidad por el diseño del producto y del flujo de datos hacia y a través de su plataforma. Recordemos a los olvidadizos que el TJUE declaró a la Iglesia de los Testigos de Jehová corresponsable por los tratamientos de datos personales captados por sus pastores aun sin tener la organización acceso a los mismos.
.- Meta se reserva un derecho de uso sobre todos los contenidos subidos a y distribuidos a través de su plataforma. Y su algoritmo determina la prioridad, número de usuarios… a las que se muestra en el feed de cada plataforma (caso “Coyote”, anybody?) Su papel es cualquier cosa menos neutro.
.- Hasta la interpretación más restrictiva de la doctrina SRB Scania, coincide en que desde el momento en que cualquier destinatario identifique a la/s persona/s incluida/s en el contenido subido, el tratamiento de datos personales cristaliza aguas abajo en toda la cadena previa de transmisiones.
.- Por último, (esto es un pensamiento adicional, sin relación con el doc comentado) asumir, por defecto, que la plataforma no tiene medios razonables para identificar a las personas incluidas en el contenido subido, es cuando menos arriesgado en el caso de Meta: uno de los Leviathanes de datos más importantes del planeta.
5.-

.- Esto del “form of awareness” ni siquiera sé de dónde lo ha sacado.
.- Efectivamente, una webcam puede mostrar la imagen de personas a millones de potenciales espectadores y quizá ninguno de ellos pueda identificarlas. Pero no es este precisamente el riesgo que presentan las Meta Glasses ni que preocupa a la ciudadanía y autoridades. De nuevo se erige la excepción en regla.
.- Y se está olvidando de nuevo de que esos datos se distribuyen a través de la plataforma de Meta, que los trata como responsable y con todas sus capacidades de reidentificación si así le interesa para sus finalidades.
6.-

.- Que un profesional tan apegado a comentar las últimas novedades de las autoridades y jurisprudencia se remonte aquí a un documento del habitualmente denostado EDPB del 2019 y se olvide de la muy famosa sentencia C-422/2024 del TJUE… es enternecedor.
El one-liner de esta sentencia es que cuando una cámara corporal obtiene datos (imágenes) por observación, la obligación de informar se rige por el art. 13 y no por el 14 RGPD; lo que impone el suministro de la información obligatoria “in situ” y “just in time”.
¿Es excesivo? ¿Es fácil? Nadie dice que lo sea. Pero es la referencia más reciente y ajustada al caso.
7.-

.- Otro clásico: por supuesto, restrinjamos toda la responsabilidad al usuario “que instiga” el tratamiento. Esta parte me decepciona: uno esperaba que le embriscaran sin complejos toda la responsabilidad a la persona grabada, que osa salir a la calle a cara descubierta.
.- De nuevo: busquemos una excepción a la promesa (perdón, perdón) premisa general, y generalicemos desde ahí. Schopenhauer kicks in!
8.-
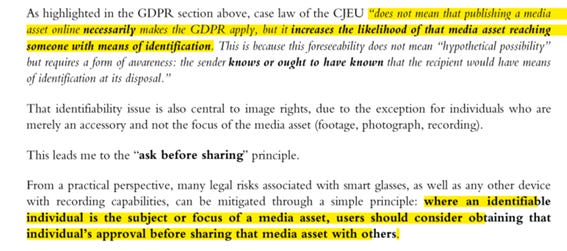
La conclusión es la propuesta del principio “ask before sharing”.
En un doc de tono por lo demás jurídico, se propone algo tan vago y conveniente como “pregunta”: no se concreta ni se habla de “consentimiento” o “interés legítimo”. Normal, porque ambos exigen un alto estándar de información previa sobre el tratamiento, cosa que -por lo que sea- se suele omitir en este tipo de artículos.
Y es que el principal problema es el de transparencia en un dispositivo que se promueve como de consumo masivo: brilla por su ausencia cualquier esfuerzo técnico serio para permitir a las personas a su alrededor ser conscientes de que se está grabando y/o difundiendo la grabación.
Así pues:
1.- Meta sabe muy bien lo que vende.
2.- El usuario sabe muy bien lo que compra.
3.- Y por supuesto que la tecnología es valiosa y se puede utilizar de forma correcta, ética y legal: faltaría más.
Sencillamente, las tres cosas son ciertas a la vez.
Estás leyendo ZERO PARTY DATA. La newsletter sobre actualidad y derecho tecnológico de Jorge García Herrero y Darío López Rincón.
En los ratos libres que nos deja esta newsletter, resolvemos movidas complicadas relacionadas con la normativa de protección de datos personales e inteligencia artificial. Si tienes de alguna de esas, haznos así con la manita. O contáctanos por correo en jgh(arroba)jorgegarciaherrero.com
🗞️Noticias del Mundodato 🌍
.- A pet portrait app with hamsters in Bermuda shorts is the cover for a network of more than 400 domains and applications linked to Chinese developers and KeLing Technology that, under certain conditions, load a web interface to generate sexual deepfakes with scenes of rape and knives at the neck. WIRED documents the mechanics: each download calls a server that decides, based on things like origin, language and identifier, whether to show the innocuous or the sleazy version, and one of the triggers -to no one’s surprise- is coming from an ad on Meta.
.- Excellent article by Gema Lendoiro in El País on identity and self-esteem (or lack thereof) in the age of social networks: “It is no longer enough to live something; we need to see it reflected, shared and validated by others”. The construction of your public image or personal brand and the unpredictability of what will or will not get likes make your ego locked in a cage with Skinner’s arts.
If, moreover, what we have in front of us is a double mirror, and the new analytical capabilities are on the other side… well. If you’re only going to open one link today, let it be this one.
.- This article by writer Joe Dunthorne in The Guardian gets darker as it progresses: Would you be thrilled if your favorite literary author wrote to you to ask for your opinion on their work? Well, hold onto your horses…
📖 Hard data documents for caffeine lovers☕️
.- The German Bundesgerichtshof asks the CJEU if a social network that selects, orders, presents and recommends third-party content through algorithms can continue to take refuge in the safe harbor of hosting while swearing it has “actual knowledge” of nothing, precisely because everything is done by a machine. The preliminary question (VI ZR 64/24) overlaps with Like Company, Coyote and Russmedia, and adds a second question as interesting as it is uncomfortable: when a court orders the removal of “equivalent” content to that declared illegal, can it be required from the platform a contextual assessment, even manual, or is this already the general monitoring prohibited? Via Mirko Brüß.
Again: we all have the answer in our heads, but there are those who make a living delaying pushing the sword of Damocles as far away from their forehead as possible… upwards.
.- Very interesting case that I will link to other things next week: The stable partner of the patient has standing to claim material liability when the health service omits to inform of the risk of failure of a vasectomy. So rules the STS of October 21, 2026, which Ignacio Serrano comments with reason as a curious case: informed consent is an exclusive right of the patient (nothing more and nothing less than… ¡¡Agapito in the pseudonymization of the CENDOJ!!). There is no shared ownership of the right to be informed. The interest lies in the dissociation between the right to be informed to consent and the right to be compensated.
.- The CNIL fines Fnac Darty Participations et Services (€6 million) and Fnac Direct (€1 million) for a tracker in their mobile app. The CNIL rejects that “navigation assistance” is strictly necessary: promoting sales is not providing the requested service. Two interesting technical details: the multifinality doctrine of the tracker (if one purpose requires consent, so does the whole) applies and the fine is calculated based on the group’s turnover, €10 billion, not on the holding company, as the sanctioned party claimed.
.- The Advocate General Szpunar considers in Like Company contra Google that Article 4 of the DSM Directive may cover the training of LLMs, including commercial. Marco Scialdone summarizes the reasoning: training is text and data mining because it extracts statistical patterns that become parameters, and subsequent use to generate text does not alter that classification; the exception covers scraping, storage of the dataset and copies during training, but only as long as they are necessary; lawful access excludes pirate websites and bypassing paywalls or anti-bot measures.
💀Death by Meme🤣
🤖NoRobots.txt o Lo de la IA
.- While the EDPB and others continue to cook the joint and official model of FRIA, Luis Alberto Montezuma compiles all relevant official documents on the subject published to date. Make “awwwwwww” as he would while you download them all…
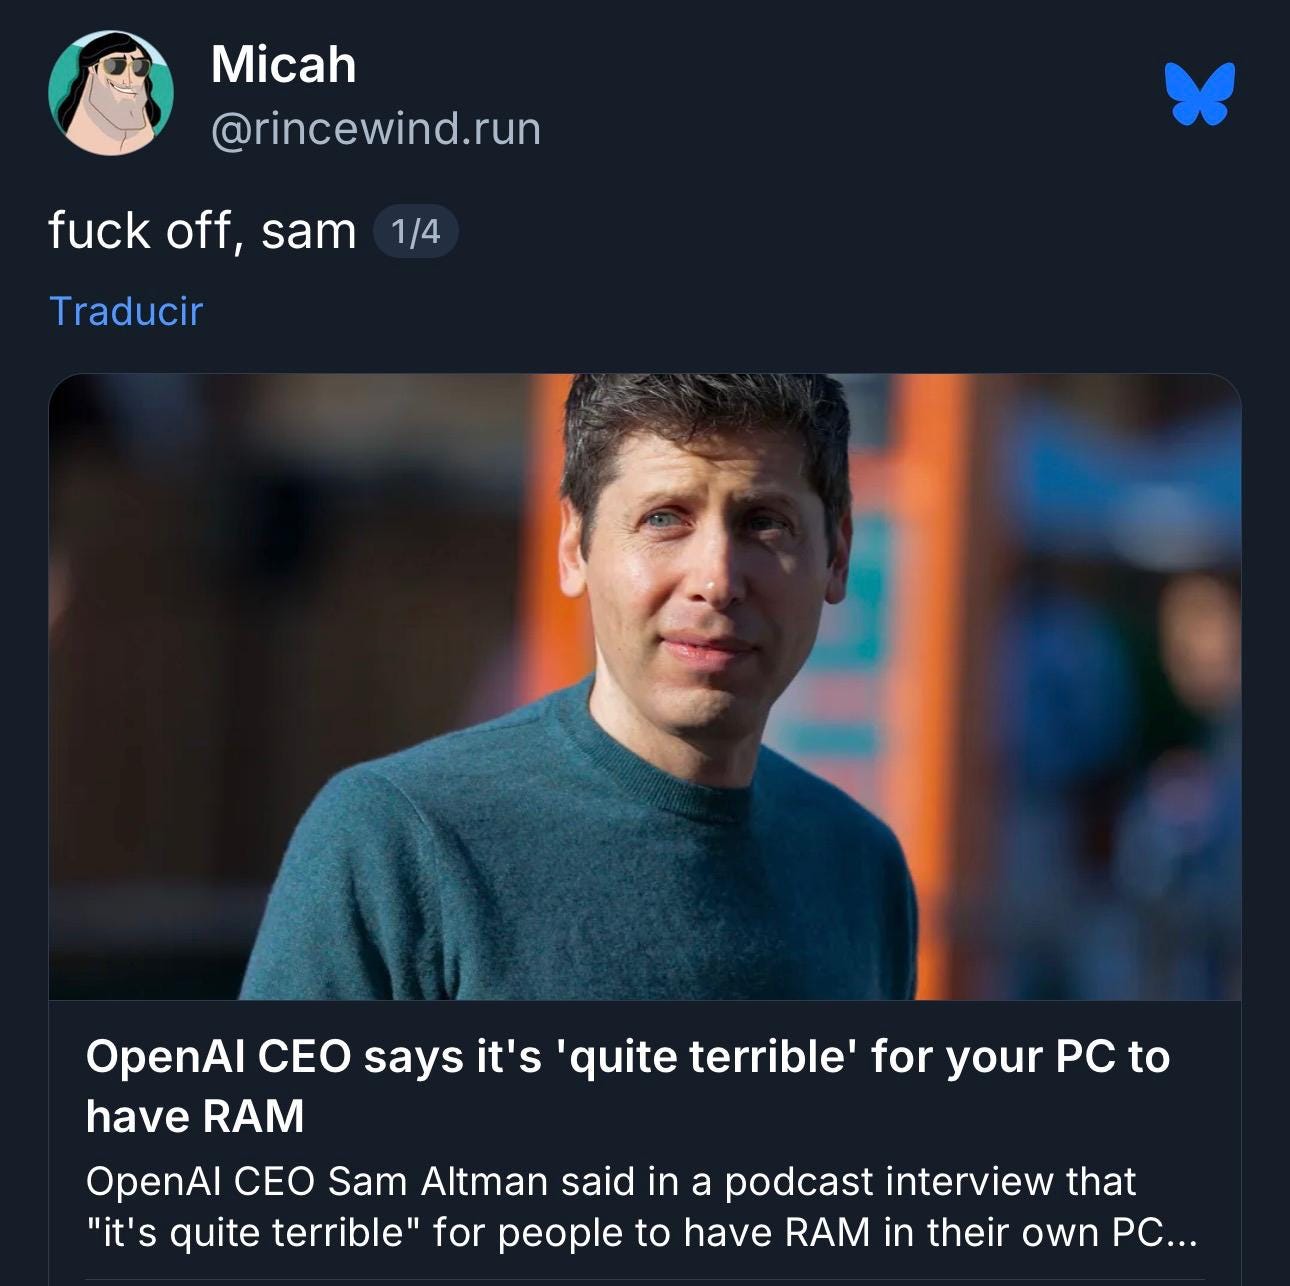
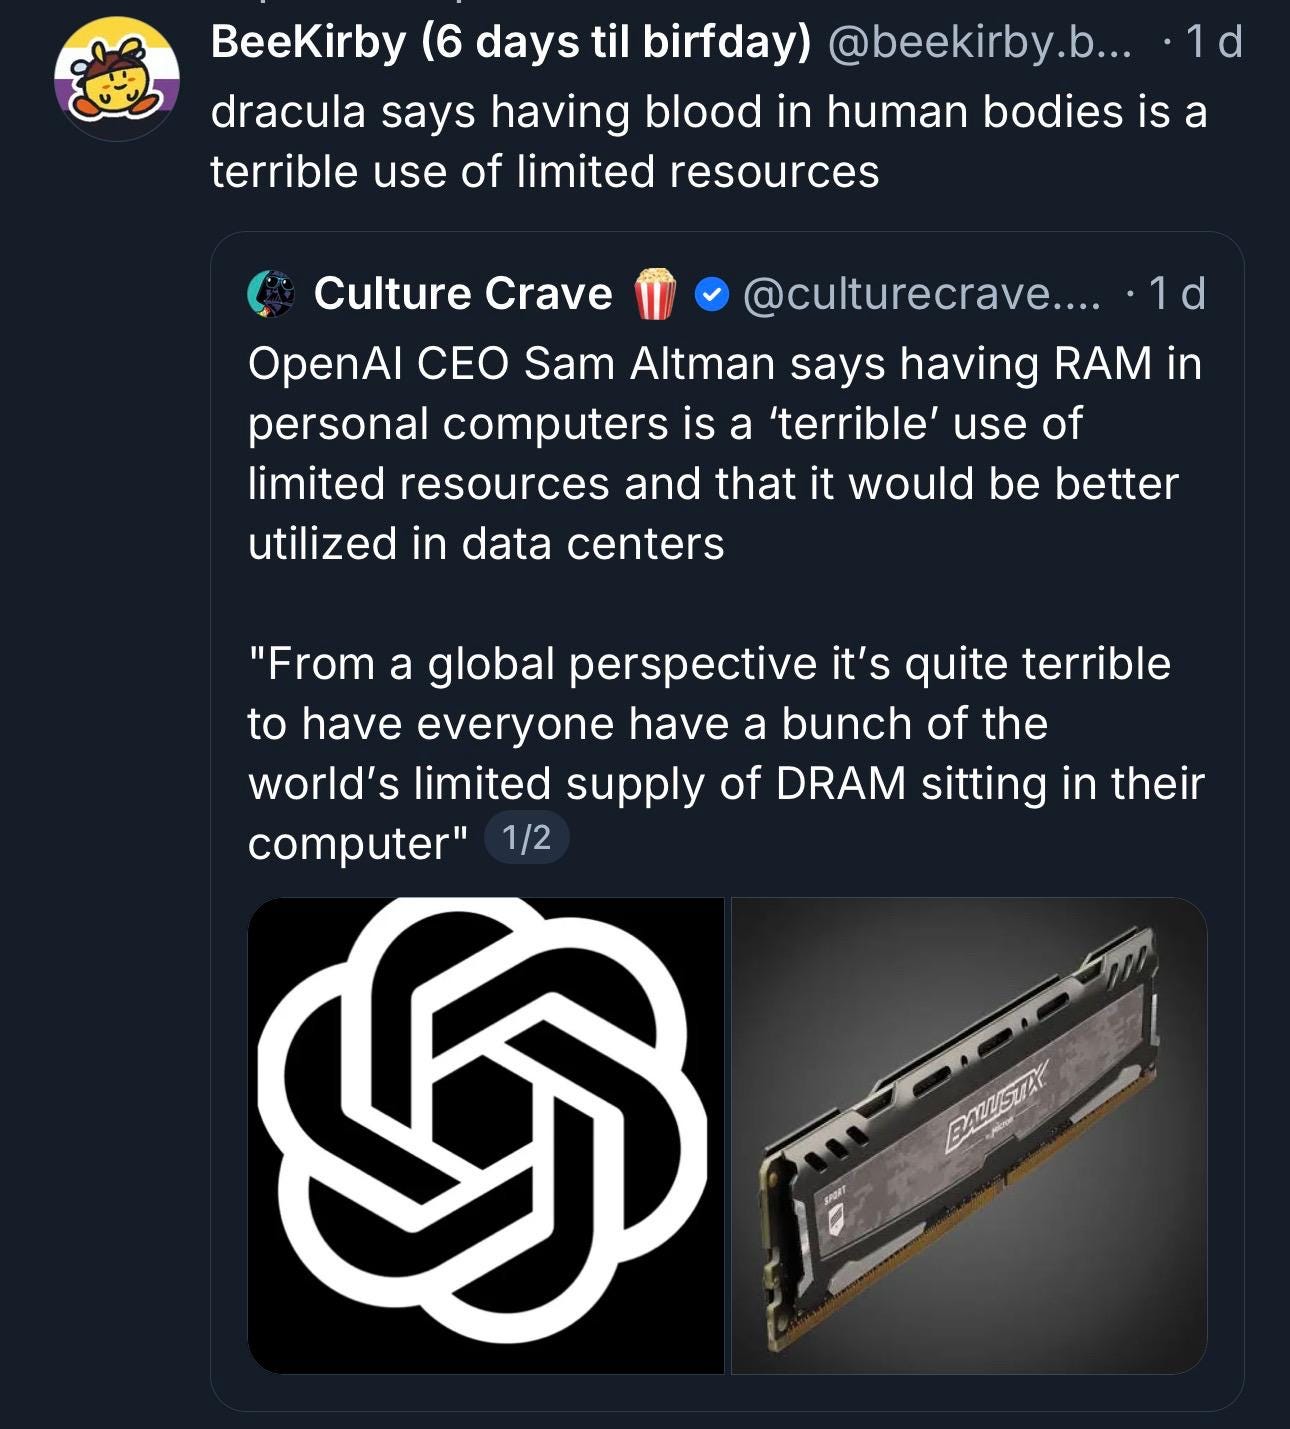
.- The AI infrastructure not only competes for our electricity and water, it also competes for the memory of your phone, in the case of Apple, and that of your home computers, in Sam Altman’s case…
.- Another notch on Meta’s revolver: rejected removing videos generated by AI of coaches groping gymnasts and dancers with adolescent appearance when normal users reported them… but removed them immediately once a journalist asked. Futurism reported ten accounts from a current account; a week later, eight received the standard message that they did not violate community standards. After the magazine’s entry, all disappeared and support responses were retroactively rewritten. Nice.
1. 📃The paper of the week
.- A frontier model can read and write directly the weights of another neural network, without gradients or training loops.
Authors: Rikiya Takehi, Jayden Teoh, Alex Zhang and others.
.- Hospitals have autonomous responsibility, not only derived from that of the doctor, when deploying clinical decision support systems. This article from the University of Bologna reconstructs a five-phase cycle (pre-acquisition, acquisition, integration, routine use and re-evaluation) and catalogues fourteen organizational failures that can found direct fault: from not reviewing Article 13 RIA documentation to workflows that make human supervision unfeasible or not removing obsolete systems.
Authors: Claudia Giorgetti, Giuseppe Contissa, Arianna Giorgetti
🛠️Useful tools
.- Clauseo has published stetdoc on github. Stetdoc allows an AI agent to edit .docx files leaving each change as a Word revision with its name and returning untouched everything it did not touch. If by chance you are a lawyer and move gazillions of word documents in redline versions, Stetdoc is going to save you a lot of tokens. I have tried it and it works excellently: highly recommended.
.- UC Berkeley releases FreeToken, an inference engine that treats GPU, CPU, host memory and PCIe as a single platform to run frontier-scale MoE models on consumer hardware. Result (promised): a laptop with 8 GB of VRAM runs Qwen3.6-35B and an RTX 5090 moves DeepSeek-V4-Flash. Loads safetensors without conversion and exposes APIs compatible with OpenAI and Anthropic on localhost. For compliance, the news is that the “frontier model without leaving the office” stops being a budget excuse: international data transfer is avoided with mid-range hardware.
I haven’t tried this one yet, but I’m listening TO YOU.
.- When is it a good idea to search with a traditional search engine instead of a chatbot, and vice versa? Wired answers.
🙄 The final nonsense
Si echas de menos algun doc, comentario o chorradón que manifiestamente debería haber estado en el Zero Party Data de la semana, escríbenos o deja un comentario y lo valoraremos para la próxima.