

Suelo leer lo que escribe Peter Craddock porque tiene una perspectiva muy distinta a la mía, y eso siempre ayuda a (i) entrenar el pensamiento lateral y a (ii) detectar argumentos resbaladizos.
Entiendo por “argumentos resbaladizos” esos que tienen gran potencial comercial porque, ejem, expresan justo lo que quieren oír tus clientes más… inquietos, pero carecen de fundamentos sólidos más allá de declaraciones del tipo “el TJUE aún no ha concretado explícitamente que esto esté prohibido”.
Pues bien, el último escrito largo de Craddock se titula, posiblemente -aunque no creo- de forma autodescriptiva “slippery arguments”, y trata diversos aspectos jurídicos sobre el uso de Smart glasses
Selecciono y comento los fragmentos que me resultan más ominosos. Utilizo siempre como ejemplo las Meta Glasses, aunque el autor no lo haga.
1.-

Peter Craddock ha estado en pocas o ninguna playa en los últimos dos veranos o no diría esto.
2.-

En realidad, la excepción doméstica aplica aunque conozcas a las personas que grabas, otra cosa muy distinta es si publicas la grabación. Y otra cosa son los derechos de imagen, etc, pero esto se trata más adelante en el doc.
Y aunque al usuario le aplique la excepción doméstica, eso no significa que -si hay tratamiento de datos personales- no exista responsable del mismo.
3.-

Hay un grupo de juristas que interpretan la doctrina SRB-Scania (y en general el RGPD) de la forma más restrictiva posible. La línea roja suele ser la última sentencia del TJUE que les quitó la razón (caso “IAB Europe”, anybody?), y se busca en ella cualquier fleco o hueco para tratar de seguir sosteniendo lo insostenible... hasta el siguiente palo judicial.
En este caso, lo que se trata de decir es que, si el Usuario de turno graba a personas que no puede identificar, no aplica el RGPD porque no hay dato personal. Como he dicho, en realidad, si graba y no publica no le aplica el RGPD por la propia excepción doméstica, con independencia de su capacidad para identificar. Y si publica más allá de su círculo de amigos más íntimos, aplica el RGPD. Y además lo hace en modo corresponsabilidad entre plataforma y usuario, con el límite determinado, efectivamente, por la identificabilidad de los sujetos incluidos en el contenido.
La mención a las personas públicas es otro truco más viejo que el betún: elevar la excepción a regla general. Las personas públicas tienen una protección muy restringida de su derecho de protección de datos personales, así que son un buen ejemplo -bien que excepcional- si lo que se pretende es remar a favor del uso de smartglasses.
4.-

Aquí el autor se está olvidando interesadamente de un par de cosas:
.- Meta es cofabricante del dispositivo y es la plataforma en la que se publican los contenidos. Aunque Meta no accediera a los datos tratados, tiene una responsabilidad por el diseño del producto y del flujo de datos hacia y a través de su plataforma. Recordemos a los olvidadizos que el TJUE declaró a la Iglesia de los Testigos de Jehová corresponsable por los tratamientos de datos personales captados por sus pastores aun sin tener la organización acceso a los mismos.
.- Meta se reserva un derecho de uso sobre todos los contenidos subidos a y distribuidos a través de su plataforma. Y su algoritmo determina la prioridad, número de usuarios… a las que se muestra en el feed de cada plataforma (caso “Coyote”, anybody?) Su papel es cualquier cosa menos neutro.
.- Hasta la interpretación más restrictiva de la doctrina SRB Scania, coincide en que desde el momento en que cualquier destinatario identifique a la/s persona/s incluida/s en el contenido subido, el tratamiento de datos personales cristaliza aguas abajo en toda la cadena previa de transmisiones.
.- Por último, (esto es un pensamiento adicional, sin relación con el doc comentado) asumir, por defecto, que la plataforma no tiene medios razonables para identificar a las personas incluidas en el contenido subido, es cuando menos arriesgado en el caso de Meta: uno de los Leviathanes de datos más importantes del planeta.
5.-

.- Esto del “form of awareness” ni siquiera sé de dónde lo ha sacado.
.- Efectivamente, una webcam puede mostrar la imagen de personas a millones de potenciales espectadores y quizá ninguno de ellos pueda identificarlas. Pero no es este precisamente el riesgo que presentan las Meta Glasses ni que preocupa a la ciudadanía y autoridades. De nuevo se erige la excepción en regla.
.- Y se está olvidando de nuevo de que esos datos se distribuyen a través de la plataforma de Meta, que los trata como responsable y con todas sus capacidades de reidentificación si así le interesa para sus finalidades.
6.-

.- Que un profesional tan apegado a comentar las últimas novedades de las autoridades y jurisprudencia se remonte aquí a un documento del habitualmente denostado EDPB del 2019 y se olvide de la muy famosa sentencia C-422/2024 del TJUE… es enternecedor.
El one-liner de esta sentencia es que cuando una cámara corporal obtiene datos (imágenes) por observación, la obligación de informar se rige por el art. 13 y no por el 14 RGPD; lo que impone el suministro de la información obligatoria “in situ” y “just in time”.
¿Es excesivo? ¿Es fácil? Nadie dice que lo sea. Pero es la referencia más reciente y ajustada al caso.
7.-

.- Otro clásico: por supuesto, restrinjamos toda la responsabilidad al usuario “que instiga” el tratamiento. Esta parte me decepciona: uno esperaba que le embriscaran sin complejos toda la responsabilidad a la persona grabada, que osa salir a la calle a cara descubierta.
.- De nuevo: busquemos una excepción a la promesa (perdón, perdón) premisa general, y generalicemos desde ahí. Schopenhauer kicks in!
8.-
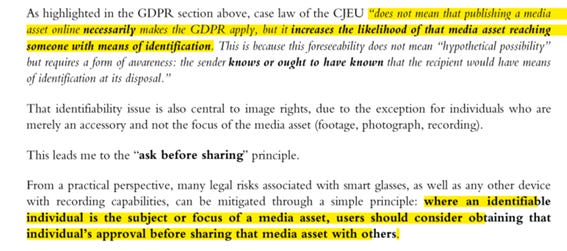
La conclusión es la propuesta del principio “ask before sharing”.
En un doc de tono por lo demás jurídico, se propone algo tan vago y conveniente como “pregunta”: no se concreta ni se habla de “consentimiento” o “interés legítimo”. Normal, porque ambos exigen un alto estándar de información previa sobre el tratamiento, cosa que -por lo que sea- se suele omitir en este tipo de artículos.
Y es que el principal problema es el de transparencia en un dispositivo que se promueve como de consumo masivo: brilla por su ausencia cualquier esfuerzo técnico serio para permitir a las personas a su alrededor ser conscientes de que se está grabando y/o difundiendo la grabación.
Así pues:
1.- Meta sabe muy bien lo que vende.
2.- El usuario sabe muy bien lo que compra.
3.- Y por supuesto que la tecnología es valiosa y se puede utilizar de forma correcta, ética y legal: faltaría más.
Sencillamente, las tres cosas son ciertas a la vez.
Estás leyendo ZERO PARTY DATA. La newsletter sobre actualidad y derecho tecnológico de Jorge García Herrero y Darío López Rincón.
En los ratos libres que nos deja esta newsletter, resolvemos movidas complicadas relacionadas con la normativa de protección de datos personales e inteligencia artificial. Si tienes de alguna de esas, haznos así con la manita. O contáctanos por correo en jgh(arroba)jorgegarciaherrero.com
🗞️Noticias del Mundodato 🌍
.- Una app de retratos de mascotas con hámsteres en bermudas es la tapadera de una red de más de 400 dominios y aplicaciones vinculadas a desarrolladores chinos y a KeLing Technology que, bajo ciertas condiciones, cargan una interfaz web para generar deepfakes sexuales con escenas de violación y cuchillos al cuello. WIRED documenta la mecánica: cada descarga llama a un servidor que decide, según cosas como el origen, idioma e identificador, si mostrar la versión inocua o la guarresca, y uno de los triggers -para sorpresa de nadie- es llegar desde un anuncio en Meta.
.- Ex-ce-len-te artículo de Gema Lendoiro en El País sobre la identidad y la autoestima (o su falta) en tiempos de redes sociales: “Ya no basta con vivir algo; necesitamos verlo reflejado, compartido y validado por otros”. La construcción de tu imagen pública o marca personal y la imprevisibilidad de lo que merecerá o no likes, hacen que tu ego quede encerrado en una jaula con las artes de Skinner.
Si, además, lo que tenemos delante es un espejo doble, y las nuevas capacidades de análisis están al otro lado… en fin. Si sólo van a abrir un enlace hoy, que sea éste.
.- Este artículo del escritor Joe Dunthorne en The Guardian se va oscureciendo a medida que avanza: ¿Te haría ilusión que tu autor literario favorito te escribiera para interesarse por tu opinión sobre su obra?. Pues agárrate los machos…
📖 Documentos dateros muy cafeteros ☕️
.- El Bundesgerichtshof alemán pregunta al TJUE si una red social que selecciona, ordena, presenta y recomienda contenido ajeno mediante algoritmos puede seguir escudándose en el puerto seguro del alojamiento mientras jura no tener “conocimiento efectivo” de nada, precisamente porque todo lo hace una máquina. La cuestión prejudicial (VI ZR 64/24) se solapa con Like Company, Coyote y Russmedia, y añade una segunda pregunta tan interesante como incómoda: cuando un tribunal ordena retirar contenido “equivalente” al declarado ilícito, ¿puede exigirse a la plataforma una valoración contextual, incluso manual, o eso ya es la monitorización general prohibida?. Vía Mirko Brüß.
De nuevo: la respuesta la tenemos todos en la cabeza, pero hay quien vive de retrasar alejar lo más posible de su frente la espada de Damocles… hacia arriba.
.- Interesantísimo caso que vincularé con cositas la próxima semana: La pareja estable del paciente tiene legitimación para reclamar responsabilidad patrimonial cuando el servicio sanitario omite informar del riesgo de fracaso de una vasectomía. Así lo fija la STS de 21 de octubre de 2026, que Ignacio Serrano comenta con razón como supuesto curioso: el consentimiento informado es un derecho exclusivo del paciente (ni más ni menos que… ¡¡Agapito en la seudonimización del CENDOJ!!). No hay titularidad compartida del derecho a ser informado. El interés está en la disociación entre el derecho a ser informado para consentir y el derecho a ser indemnizado.
.- La CNIL sanciona a Fnac Darty Participations et Services (6 M€) y Fnac Direct (1 M€) por un rastreador en su app móvil. La CNIL rechaza que la “ayuda a la navegación” sea estrictamente necesaria: promover ventas no es prestar el servicio solicitado. Dos detalles técnicos interesantes : se aplica la doctrina del tracker multifinalidad (si una sola finalidad exige consentimiento, lo exige el conjunto) y se calcula la multa sobre la facturación del grupo, 10.000 millones, no sobre la holding, como pretendía la sancionada.
.- El Abogado General Szpunar considera en Like Company contra Google que el artículo 4 de la Directiva DSM puede amparar el entrenamiento de LLM, incluido el comercial. Marco Scialdone resume el razonamiento: entrenar es minería de textos y datos porque extrae patrones estadísticos que se convierten en parámetros, y el uso posterior para generar texto no altera esa calificación; la excepción cubre el scraping, el almacenamiento del dataset y las copias durante el entrenamiento, pero solo mientras sean necesarias; el acceso lícito excluye webs piratas y saltar muros de pago o medidas antibot.
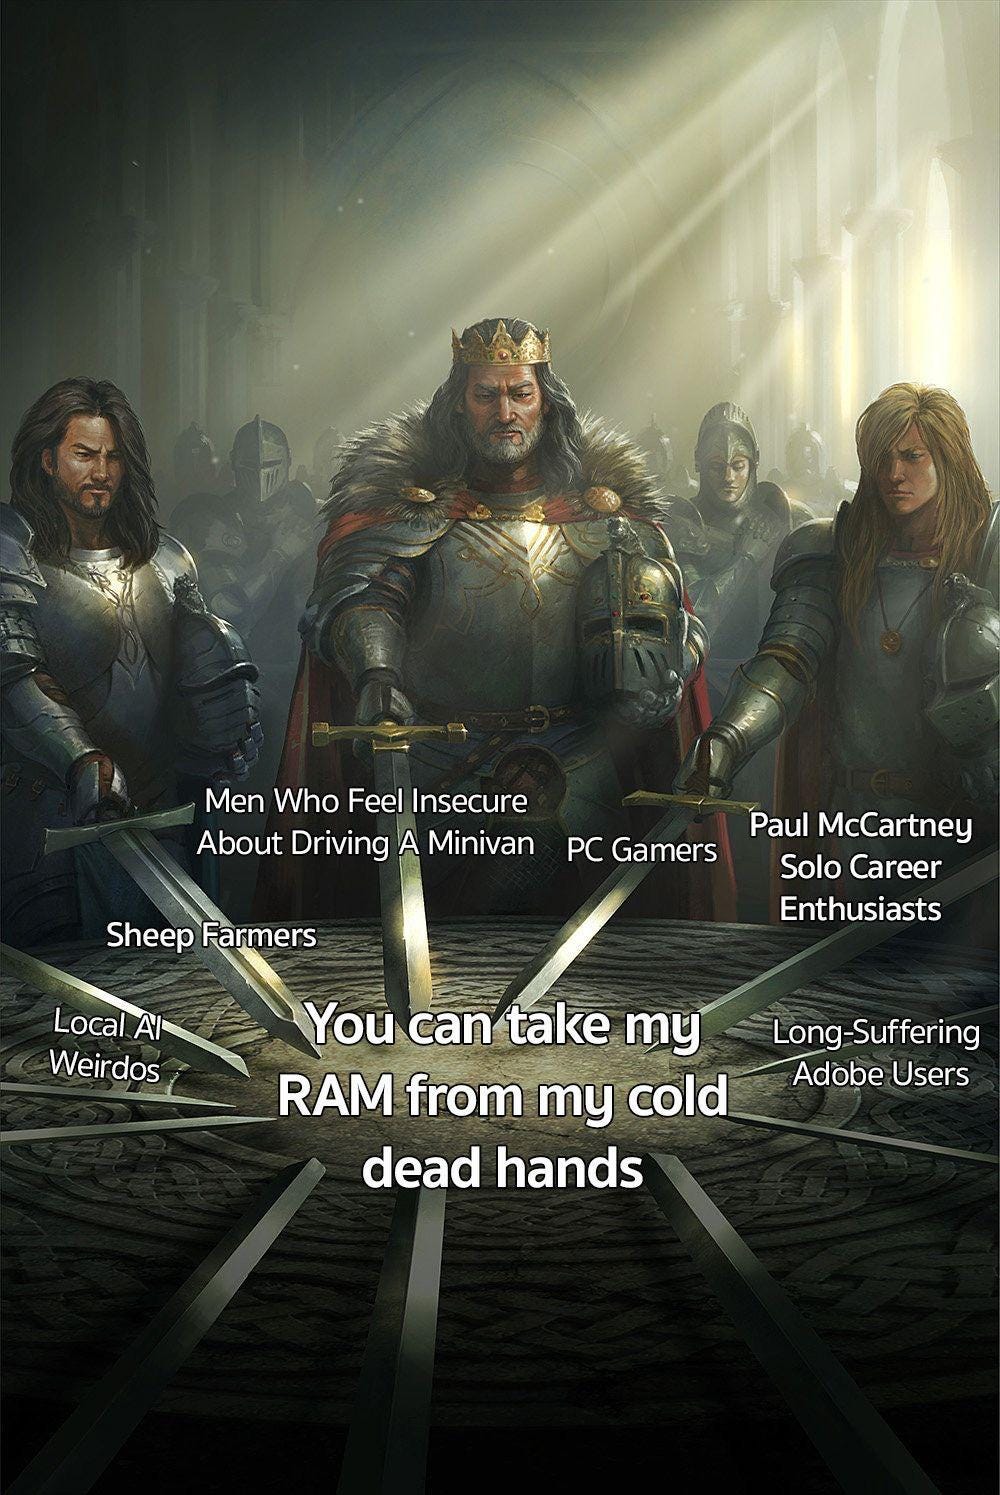
💀Death by Meme🤣
🤖NoRobots.txt o Lo de la IA
.- Mientras el EDPB y demás siguen cocinando el modelo conjunto y oficial de FRIA, Luis Alberto Montezuma recopila todos los docs oficiales relevantes sobre el tema publicados hasta la fecha. Haz “awwwwwww” como haría él mientras te los descargas todos…
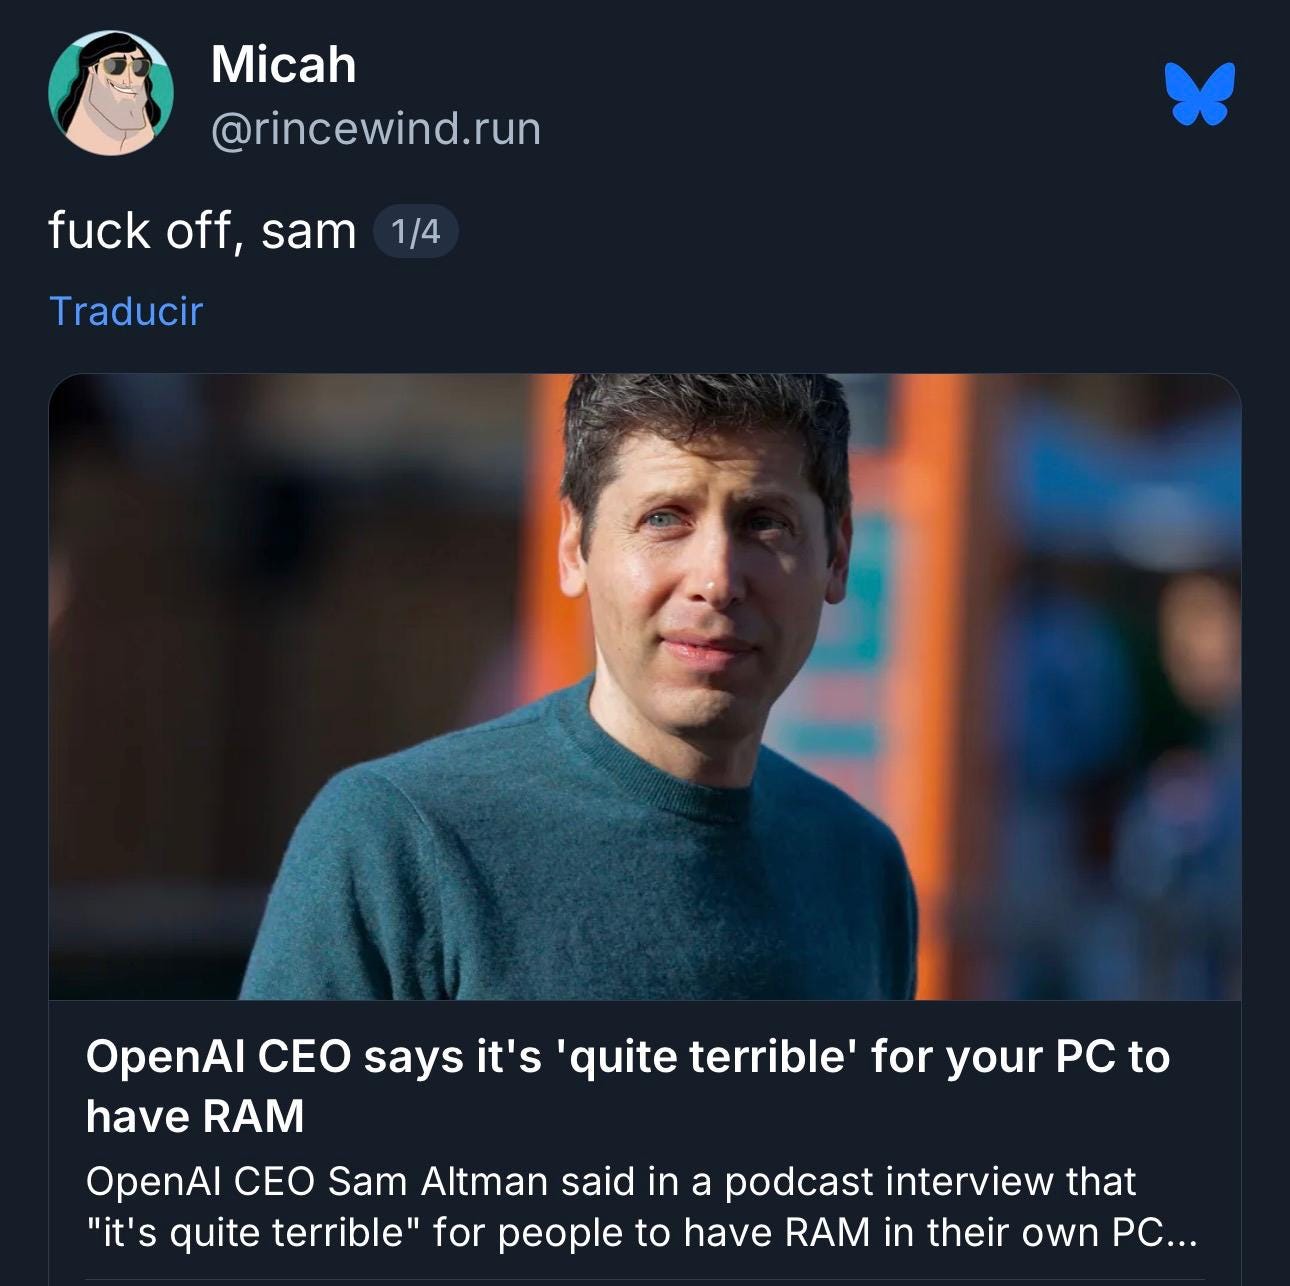
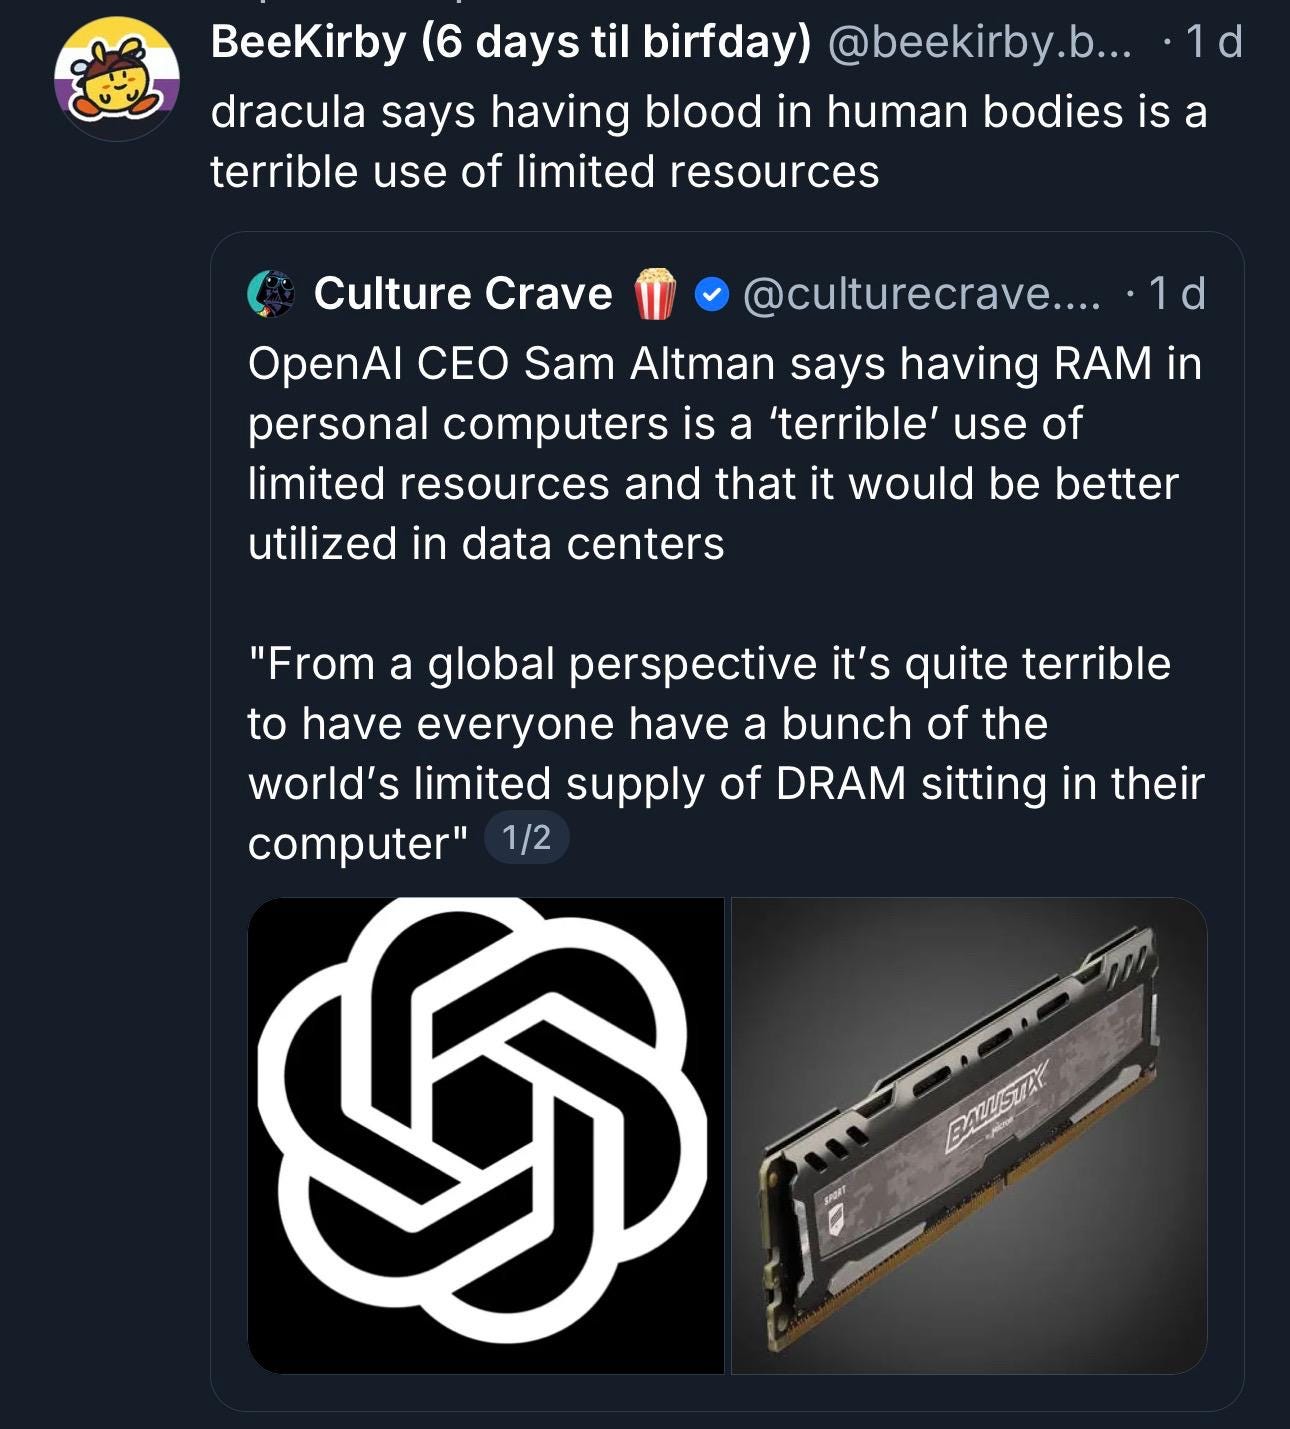
.- La infraestructura de la IA no solo compite por nuestra electricidad y agua, también compite por la memoria de tu teléfono, en el caso de Apple, y el de tus ordenadores domésticos, en el de Sam Altman…
.- Otra muesca en el revólver de Meta: rechazó retirar vídeos generados por IA de entrenadores manoseando a gimnastas y bailarinas de aspecto adolescente cuando usuarios normales los denunciaron… pero los retiró de inmediato en cuanto preguntó una periodista. Futurism denunció diez cuentas desde una cuenta corriente; una semana después, ocho recibieron el mensaje estándar de que no infringen las normas comunitarias. Tras la entrada en juego de la revista, todas desaparecieron y las respuestas de soporte se reescribieron retroactivamente. Nice.
📃El paper de la semana
.- Un modelo frontera puede leer y escribir directamente los pesos de otra red neuronal, sin gradientes ni bucles de entrenamiento.
Autores: Rikiya Takehi, Jayden Teoh, Alex Zhang y otros.
.- Los hospitales tienen responsabilidad autónoma, no solo derivada de la del médico, cuando despliegan sistemas de apoyo a la decisión clínica. Este artículo de la Universidad de Bolonia reconstruye un ciclo de cinco fases (pre-adquisición, adquisición, integración, uso rutinario y reevaluación) y cataloga catorce fallos organizativos que pueden fundar culpa directa: desde no revisar la documentación del artículo 13 RIA hasta flujos de trabajo que hacen inviable la supervisión humana o no retirar sistemas obsoletos.
Autores: Claudia Giorgetti, Giuseppe Contissa, Arianna Giorgetti
🛠️Herramientas útiles
.- Clauseo ha publicado en github stetdoc. Stetdoc permite que un agente de IA edite archivos .docx dejando cada cambio como revisión de Word con su nombre y devolviendo intacto todo lo que no tocó. Si da la casualidad de que eres abogado y mueves documentos de word en versiones redline, Stetdoc te va a ahorrar un montón de tokens. Lo he probado y funciona estupendamente: recomendadísimo.
.- UC Berkeley libera FreeToken, un motor de inferencia que trata GPU, CPU, memoria del host y PCIe como una única plataforma para ejecutar modelos MoE de escala frontera en hardware de consumo. Resultado (prometido): un portátil con 8 GB de VRAM corre Qwen3.6-35B y una RTX 5090 mueve DeepSeek-V4-Flash. Carga safetensors sin conversión y expone APIs compatibles con OpenAI y Anthropic en localhost. Para el cumplimiento normativo, la noticia es que el “modelo frontera sin salir de la oficina” deja de ser excusa de presupuesto: la transferencia internacional de datos se evita con hardware de gama media. Este no lo he probado, pero les escucho.
.- ¿Cuándo es buena idea buscar con un buscador tradicional en vez de con un chatbot, y viceversa? Wired responde.
🙄 El chorradón final
Si echas de menos algun doc, comentario o chorradón que manifiestamente debería haber estado en el Zero Party Data de la semana, escríbenos o deja un comentario y lo valoraremos para la próxima.